Муниципальный этап, 9–11 классы всероссийской олимпиады по информатике: 5 задач с официальным разбором, к каждой наше решение на C++.
К задаче 1Муниципальный этап ВсОШ по информатике 2024/25, 9–11 классы.
Задачи тура
- 1Речные прогулкиматематика
- 2Треугольникиматематика, комбинаторика
- 3Порядок во всёмжадный алгоритм, строки
- 4Тройкадинамическое программирование, битовые маски
- 5Все на съезд!перебор
Отмечайте решённые: 0 из 5
1. Речные прогулки
Вдоль течения реки размещены пристаней, пронумерованных числами от 1 до . Пристань номер 1 находится выше всех остальных по течению реки, пристань номер находится в устье реки, расстояние между соседними пристанями равно 1 км.
Для развития туризма решено открыть два прогулочных речных маршрута. Маршруты будут начинаться на одной из промежуточных пристаней (пристани номер 1 или не могут быть начальными точками маршрутов), один маршрут будет идти вверх по течению реки к пристани номер 1, другой маршрут будет идти вниз по течению к пристани номер . Промежуточных остановок на маршрутах нет.
Для подъёма вверх по течению реки судно тратит минут на один километр, а для спуска вниз по течению реки минут на один километр. Определите, на какой пристани должны начинаться оба маршрута, чтобы их продолжительности различались как можно меньше. Это значит, что необходимо минимизировать модуль разности времени в пути двух маршрутов.
Формат входных данных
Первая строка входных данных содержит целое число () — общее количество пристаней на маршруте. Вторая строка содержит число — время подъёма судна на один километр вверх по течению реки, третья строка содержит число — время спуска на один километр вниз по течению, .
Формат выходных данных
Программа должна вывести одно число — номер пристани, на которой необходимо организовать начальный пункт маршрутов. Если возможных подходящих ответов несколько, можно вывести любой из них.
Система оценки
Решения, правильно работающие, когда все входные числа не превосходят 100, будут оцениваться в 60 баллов.
Замечание
В примере из условия начальным пунктом маршрутов нужно сделать пристань 3. Тогда вверх по течению судно поднимется за минут, а вниз по течению реки спустится за минут. Разница в продолжительности маршрутов составит 1, меньшей разности в данном примере достичь невозможно.
| стандартный ввод | стандартный вывод |
|---|---|
8 7 3 | 3 |
Официальный разборСначала попробуйте решить сами
Наше решение на C++Полный код на C++17
Официальный разбор
Автор задачи: Денис Кириенко.
Набрать 60 баллов можно при помощи перебора по ответу. Переберём все пристани с номерами от 2 до , и для каждой из них посчитаем разность между продолжительностью пути вверх и вниз.
Пусть рассматриваемая пристань имеет номер , тогда продолжительность пути до пристани 1 равна , а вниз — . Нужно найти такую пристань , для которой модуль разности этих величин будет наименьшим.
Такое решение имеет сложность . Пример такого решения.
n = int(input())
a = int(input())
b = int(input())

def ans(x):
    return abs((x - 1) * a - (n - x) * b)

d = 2
for i in range(3, n):
    if ans(i) < ans(d):
        d = i

print(d)
Для решения на полный балл заметим, что если некоторая пристань будет ответом, то значения и будут близки. Приравняем их, откуда получим решение уравнения
Это число было бы ответом, если задача решалась в действительных числах, когда началом маршрутов может быть любая точка. Но мы рассматриваем только целочисленные значения ответа, поэтому ответом может быть одно из двух целых чисел: указанное значение , округлённое вниз и вверх. Выберем из этих значений такое, для которого модуль разности времени пути до верхней и нижней пристани будет наименьшим, учтя, что ответ не может равняться 1 и . Такое решение имеет сложность .
n = int(input())
a = int(input())
b = int(input())

def ans(pos):
    return abs((pos - 1) * a - (n - pos) * b)

d = max(2, (b * n + a) // (a + b))
if d + 1 < n and ans(d + 1) < ans(d):
    d += 1

print(d)
Также полный балл можно было набрать при помощи двоичного или троичного поиска по ответу.
Наше решение на C++
#include <bits/stdc++.h>
using namespace std;

long long n, a, b;

long long difference(long long pier) {
    return llabs((pier - 1) * a - (n - pier) * b);
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);
    cin >> n >> a >> b;
    long long best = max(2LL, (b * n + a) / (a + b));
    best = min(best, n - 1);
    if (best + 1 < n && difference(best + 1) < difference(best)) best++;
    if (best - 1 > 1 && difference(best - 1) < difference(best)) best--;
    cout << best << "\n";
    return 0;
}
2. Треугольники
Дана клетчатая сетка, состоящая из клеток со стороной 1, в каждой клетке проведены обе диагонали.
Например, сетка выглядит следующим образом:
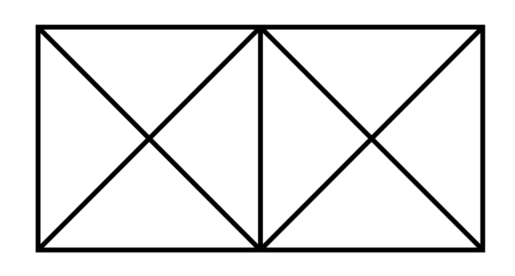
Назовём прямоугольник на данной сетке подходящим, если его вершины расположены в узлах сетки, а длины его стороны равны 1 или 2 (то есть подходящими являются прямоугольники , , , ).
Треугольник называется хорошим, если его стороны образованы сторонами и/или диагоналями сетки и он целиком лежит в каком-то подходящем прямоугольнике.
Посчитайте количество хороших треугольников на данной сетке.
Формат входных данных
Программа получает на вход два числа и , записанных в отдельных строках, — размеры сетки, , .
Формат выходных данных
Программа должна вывести одно целое число — количество искомых треугольников.
Обратите внимание на то, что ответ в этой задаче может превышать возможное значение 32-битной целочисленной переменной, поэтому необходимо использовать 64-битные целочисленные типы данных (тип long long в языке C++, тип int64 в Pascal, тип long в Java и C#).
Система оценки
В данной задаче 20 тестов помимо тестов из условия, каждый из них оценивается в 5 баллов. При этом в 4 тестах (помимо тестов из условия) или равно 1, в 4 других тестах или равно 2.
Замечание
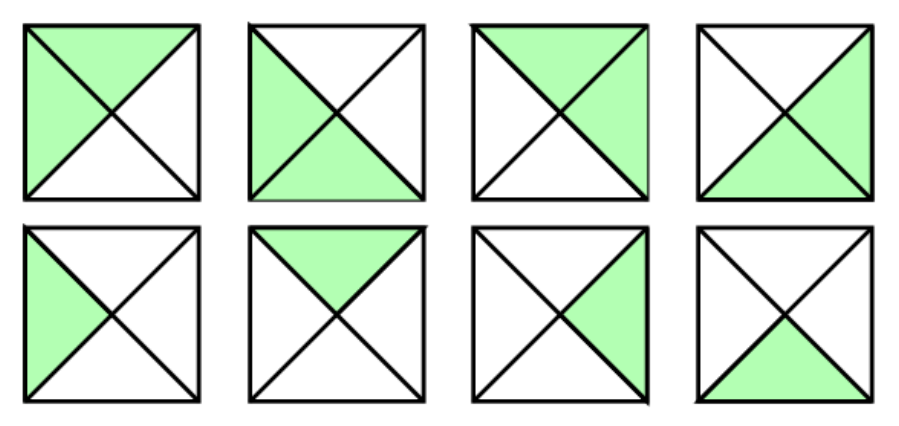
Все треугольники из первого примера:
| стандартный ввод | стандартный вывод |
|---|---|
1 1 | 8 |
| стандартный ввод | стандартный вывод |
|---|---|
1 2 | 18 |
| стандартный ввод | стандартный вывод |
|---|---|
2 2 | 44 |
| стандартный ввод | стандартный вывод |
|---|---|
3 5 | 196 |
Официальный разборСначала попробуйте решить сами
Наше решение на C++Полный код на C++17
Официальный разбор
Автор задачи: Владимир Рагулин.
Подготовка задачи: Александр Понкратов.
Внутри каждого квадрата можно выбрать 8 маленьких треугольников, как в первом примере, то есть число таких треугольников равно .
Внутри прямоугольника есть 2 больших треугольника площади 1. Прямоугольник можно выбрать способами, поэтому таких треугольников будет .
Аналогично, существует больших треугольников, расположенных внутри какого-то прямоугольника размером .
Наконец, внутри квадрата можно выбрать 4 треугольника площади 2, таких треугольников будет .
Нужно вывести сумму этих величин.
n = int(input())
m = int(input())
print(n * m * 8 + (n - 1) * m * 2 + n * (m - 1) * 2 + (n - 1) * (m - 1) * 4)
Наше решение на C++
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);
    long long n, m;
    cin >> n >> m;
    long long cells = n * m;
    long long dominoes = n * (m - 1) + (n - 1) * m;
    long long squares = (n - 1) * (m - 1);
    cout << 8 * cells + 2 * dominoes + 4 * squares << "\n";
    return 0;
}
3. Порядок во всём
Вася очень порядочный мальчик, он любит порядок во всём.
У него в тетради есть столбик натуральных чисел, и он хочет изменить его так, чтобы числа шли по порядку, то есть по неубыванию. При этом Вася, естественно, ничего не хочет зачёркивать, поэтому единственное, что ему остаётся — это дописать цифры в конец некоторых чисел.
Вася хочет, чтобы после дописывания цифр последнее число в списке оказалось наименьшим возможным. Найдите это число.
Формат входных данных
Первая строка входных данных содержит целое число () — количество чисел в тетрадке у Васи.
Следующие строк содержат чисел, записанных в тетрадке, по одному в каждой строке. Все числа натуральные, не превосходящие .
Формат выходных данных
Программа должна вывести наименьшее число, которое могло оказаться у Васи в конце списка.
Система оценки
Решения, верно работающие, когда и при этом все числа в списке однозначные, будут оцениваться в 10 баллов.
Решения, верно работающие, когда и при этом все числа в списке не превосходят 999, будут оцениваться в 20 баллов.
Решения, верно работающие, когда без дополнительных ограничений на числа, будут оцениваться в 40 баллов.
Решения, верно работающие, когда без дополнительных ограничений на числа, будут оцениваться в 60 баллов.
Замечание
В первом примере числа уже упорядочены, Васе не нужно ничего дописывать.
Во втором примере Васе можно приписать ко второму числу цифру 3, тогда числа станут равны 13, а значит, будут расположены по неубыванию. При этом 13 — это минимально возможное последнее число.
В третьем примере Вася может, например, получить числа 20, 25, 100. Возможны и другие варианты, но последнее число при любом способе дописывания цифр получится не меньше 100.
| стандартный ввод | стандартный вывод |
|---|---|
3 1 5 7 | 7 |
| стандартный ввод | стандартный вывод |
|---|---|
2 13 1 | 13 |
| стандартный ввод | стандартный вывод |
|---|---|
3 20 2 1 | 100 |
Официальный разборСначала попробуйте решить сами
Наше решение на C++Полный код на C++17
Официальный разбор
Автор задачи: Сергей Князевский.
Подготовка задачи: Владимир Ильин.
Несложно понять, что на каждом шаге нужно получить как можно меньшее число. То есть задача сводится к необходимости реализовать один шаг: даны два числа и , необходимо из числа дописыванием цифр в конец получить наименьшее число , которое не меньше .
Отметим, что задачу удобнее решать с использованием строковых типов данных, а не числовых. Если длина числа больше, чем длина числа , то и дописывать ничего не нужно.
Если длина числа не больше длины числа , то рассмотрим префикс числа , длина которого равна длине числа . Например, если , а число — двузначное, то . Поскольку числа и имеют одинаковую длину, то их можно сравнивать в лексикографическом порядке, как строки. Рассмотрим разные варианты сравнения чисел и .
Если , то число является префиксом , тогда мы можем дописать в конец цифры так, что получится число , то есть . Например, при и значение .
Если (префикс больше ), то при дописывании в конец числа новых цифр мы можем получить большее число, только когда длина числа станет больше длины числа . Тогда необходимо дописать минимальное число нулей, чтобы длина числа стала на 1 больше длины числа . Например, при и значение .
Наконец, если , то нужно дописать нули так, чтобы длины чисел и стали равны. Например, при и значение .
Пример решения на языке Python.
n = int(input())
A = input()
for i in range(n - 1):
    B = input()
    if len(A) >= len(B):
        Ap = A[:len(B)]
        if Ap == B:
            # Первый случай, дополним число B до A
            C = A
        elif Ap > B:
            # Второй случай, дополним B нулями с увеличением длины числа
            C = B + "0" * (len(A) + 1 - len(B))
        else:
            # Третий случай, дополним B нулями до длины числа A
            C = B + "0" * (len(A) - len(B))
    else:
        # Длина числа B больше длины A, поэтому ничего добавлять не надо
        C = B
    A = C
print(A)
Заметим, что длина числа может увеличиваться на 1 на каждом шаге. Если взять пример, в котором исходные числа убывают, то каждое следующее полученное число будет на 1 длиннее предыдущего числа. Например, если входные числа таковы:
9999 9998 9997 9996 9995 ...
то получатся следующие числа:
9999 99980 999700 9996000 99950000 ...
Несложно построить тест, на котором такое решение имеет сложность . Такие решения набирают 60 баллов.
Для того, чтобы набрать 100 баллов, необходимо заметить, что длины чисел увеличиваются за счёт добавления нулей в конец, и сложность возникает из-за того, что мы создаём строки увеличивающейся длины, добавляя нули в конец чисел. Большую часть ответа в этом случае составляет суффикс нулевой длины, поэтому вместо ответа в виде длинной строки будем хранить его префикс и количество нулей, которое нужно дописать в конец, в переменной zero_suff_len. Такое решение имеет сложность и набирает 100 баллов.
n = int(input())
A = input()
zero_suff_len = 0
for i in range(n - 1):
    B = input()
    if len(A) + zero_suff_len >= len(B):
        # Случай когда длина A <= длина B, но с учётом дополнительного
        # нулевого суффикса. Для построения префикса A такой же длины,
        # как B, будем добавлять в конец A нули из суффикса
        while len(A) < len(B):
            A += "0"
            zero_suff_len -= 1
        Ap = A[:len(B)]
        # Последующий разбор случаев дублирует неэффективное решение
        if Ap == B:
            C = A
        elif Ap > B:
            C = B
            zero_suff_len = zero_suff_len + len(A) + 1 - len(B)
        else:
            C = B
            zero_suff_len = zero_suff_len + len(A) - len(B)
    else:
        # Длина B больше, поэтому C = B и нужно сбросить zero_suff_len
        C = B
        zero_suff_len = 0
    A = C
print(A + "0" * zero_suff_len)
Наше решение на C++
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);
    int n;
    cin >> n;
    string base;
    long long zeros = 0;
    cin >> base;
    for (int i = 1; i < n; i++) {
        string x;
        cin >> x;
        long long length = (long long)base.size() + zeros;
        if ((long long)x.size() > length) {
            base = x;
            zeros = 0;
            continue;
        }
        string prefix;
        for (size_t k = 0; k < x.size(); k++) prefix += k < base.size() ? base[k] : '0';
        if (x == prefix) continue;
        long long newZeros = length - (long long)x.size();
        if (x < prefix) newZeros++;
        base = x;
        zeros = newZeros;
    }
    string answer = base + string(zeros, '0');
    cout << answer << "\n";
    return 0;
}
4. Тройка
Арсений очень любит пользоваться городским транспортом. В городе, где он живёт, существует карта «Тройка», позволяющая оплачивать проезд при помощи тарифа «Кошелёк». Есть два вида тарифа:
- «Единый» (57 рублей) — одна поездка на любом виде транспорта;
- «90 минут» (85 рублей) — не более одной поездки на метро и любое количество поездок на наземном транспорте в течение не более 90 минут с момента начала первой поездки (между началом поездки и началом первой поездки должно пройти не более 90 минут).
Так как Арсений коллекционирует карты «Тройка», у него их очень много, поэтому он может использовать неограниченное количество билетов одновременно.
У него есть планы на ближайшие поездок. Помогите мальчику узнать, какое минимальное количество денег он должен потратить для реализации своих планов.
Формат входных данных
Первая строка входных данных содержит целое число — количество поездок, которые были запланированы, .
Следующие строк содержат два значения, разделённые пробелом. Сначала указан вид транспорта: заглавная английская буква «B», если Арсений будет использовать наземный транспорт, или заглавная английская буква «M», если он воспользуется метро. Затем указано время начала поездки в формате ЧЧ:ММ (в виде двузначного количества часов и затем двузначного количества минут).
Поездки указаны в порядке их совершения, но они могут занимать несколько последовательных дней. Если время, записанное в какой-то строке, меньше, чем время в предыдущей строке, то данная поездка была совершена на следующий день. При этом гарантируется, что в каждый день Арсений совершит хотя бы одну поездку.
Также гарантируется, что разница времени совершения двух поездок составляет не менее 10 минут.
Формат выходных данных
Программа должна вывести одно целое число — сколько денег потратит Арсений, если будет максимально эффективно использовать карты.
Система оценки
Решения, правильно работающие при , будут набирать не менее 10 баллов.
Решения, правильно работающие, когда все поездки были совершены на метро, будут набирать не менее 15 баллов.
Решения, правильно работающие, когда все поездки были совершены на наземном транспорте, будут набирать не менее 25 баллов.
Решения, правильно работающие, когда не было совершено более двух поездок на наземном транспорте подряд, будут набирать не менее 35 баллов.
Решения, правильно работающие, когда все поездки были совершены в один день, будут набирать не менее 25 баллов.
Замечание
В первом примере все три поездки могут быть оплачены одним тарифом «90 минут» за 85 рублей.
Во втором примере нужно одним билетом «90 минут» за 85 рублей оплатить первую (23:59), вторую (00:29) и четвёртую (01:29) поездки. Третью поездку (00:59) нельзя оплатить тем же билетом, потому что в тарифе «90 минут» может быть не более одной поездки на метро, для этой поездки придётся использовать отдельный билет за 57 рублей.
В третьем примере первую поездку (22:00) нужно оплатить отдельным билетом за 57 рублей, а следующие три поездки (23:00, 23:50, 00:30) — билетом «90 минут».
| стандартный ввод | стандартный вывод |
|---|---|
3 M 10:00 B 10:20 B 11:00 | 85 |
| стандартный ввод | стандартный вывод |
|---|---|
4 B 23:59 M 00:29 M 00:59 B 01:29 | 142 |
| стандартный ввод | стандартный вывод |
|---|---|
4 B 22:00 B 23:00 B 23:50 B 00:30 | 142 |
Официальный разборСначала попробуйте решить сами
Наше решение на C++Полный код на C++17
Официальный разбор
Автор задачи: Денис Кириенко.
Подготовка задачи: Арсений Порхунов.
В этой задаче можно было придумать решения, работающие в некоторых частных случаях. Например, если все поездки были совершены на метро, то каждая поездка стоит 57 рублей, поэтому программа, выводящая число 57 * n, наберёт 15 баллов.
Отметим «жадное» решение, в котором используется только одна карта «Тройка», а все списания соответствуют правилам тарификации. То есть результат работы этого решения будет таким же, когда пассажир каждый раз при оплате проезда использует одну и ту же карту «Тройка». Для реализации этого алгоритма необходимо запоминать, сколько поездок было совершено по данному билету, сколько из этих поездок было поездок на метро и время совершения первой поездки. Такое решение набирает 30 баллов. Пример решения.
n = int(input())
subway = [1] * (n + 1)
time = [-1000] * (n + 1)
day = 0
for i in range(1, n + 1):
    trans, tm = input().split()
    tm = tm.split(":")
    time[i] = int(tm[0]) * 60 + int(tm[1]) + day * 24 * 60
    subway[i] = int(trans == "M")
    if i > 0 and time[i] <= time[i-1]:
        day += 1
        time[i] += 24 * 60
ans = [10**9] * (n + 1)
ans[0] = 0
ticket_start = -10**9
ticket_count = 0
ticket_count_subway = 0
for i in range(1, n + 1):
    if time[i] - ticket_start > 90 or ticket_count_subway + subway[i] > 1:
        ans[i] = ans[i - 1] + 57
        ticket_start = time[i]
        ticket_count = 1
        ticket_count_subway = subway[i]
    else:
        if ticket_count == 1:
            ans[i] = ans[i - 1] + 28
        else:
            ans[i] = ans[i - 1]
        ticket_count += 1
        ticket_count_subway += subway[i]
print(ans[-1])
В этом решении начальная часть заключается в считывании данных, результатом являются два списка time, в котором хранится время совершения поездки в минутах от условного нуля, с учётом перехода на следующие сутки, и subway, в котором хранится признак того, была ли эта поездка совершена на метро (число 0 или 1). Дальше опустим эту часть программы.
Рассмотренное «жадное» решение не работает, например, на третьем примере из условия, где даны 4 поездки: 22:00, 23:00, 23:50, 00:30. Это решение разобьёт их на группы (22:00, 23:00) и (23:50, 00:30), что потребует двух тарифов «90 минут», а если разбить решения на группы (22:00) и (23:00, 23:50, 00:30), то получится тариф «единый» и «90 минут». Чтобы правильно разбивать решения на группы, необходимо использовать идею динамического программирования. Пусть ans[i] — ответ для первых поездок, то есть минимальная стоимость оплаты первых поездок. Переберём все поездки, для каждой поездки рассмотрим два случая тарификации.
1. Новая поездка оплачивается по тарифу «единый». Тогда ans[i] = ans[i-1] + 57.
2. Новая поездка оплачивается по тарифу «90 минут». Переберём первую поездку по этому тарифу . Должны выполняться условия time[i] - time[j] <= 90 и сумма чисел subway[i], ..., subway[j] не больше 1. Тогда ответ равен ans[i] = ans[j-1]+85.
Из возможных способов получения ans[i] нужно выбрать наименьшее. Такое решение набирает 50 баллов. В частности, оно работает правильно, когда все поездки совершены на наземном транспорте.
ans = [10**9] * (n + 1)
ans[0] = 0
for i in range(1, n + 1):
    ans[i] = 57 + ans[i - 1]
    count_subway = subway[i]
    j = i - 1
    while j >= 1 and time[i] - time[j] <= 90:
        count_subway += subway[j]
        if count_subway > 1:
            break
        ans[i] = min(ans[i], ans[j - 1] + 85)
        j -= 1
print(ans[-1])
Это решение предполагает, что никакие два использованных тарифа не «пересекаются» по времени, то есть не бывает ситуации, когда одна поездка оплачивается по одному билету, другая поездка — по другому билету, а потом снова поездка по первом билету. Но во втором примере из условия показано, что, например, в случае четырёх поездок B, M, M, B выгодно использовать тариф «90 минут» для наземного транспорта и одной поездки на метро, и отдельный тариф «единый» для другой поездки на метро, то есть использованные билеты будут пересекаться по времени. Можно показать, что пересечения возможны, только если внутри одного тарифа «90 минут» использовать отдельные билеты для совершения поездок на метро, чтобы соблюсти условия одного тарифа «90 минут» для поездок на наземном транспорте. А пересечения тарифов «90 минут» невозможны, то есть можно построить лучшее решение, в котором использованные тарифы «90 минут» не будут пересекаться.
Чтобы учесть это в решении, введём новый вид тарифа «90 минут+», который допускает любое число поездок на любом транспорте в течение 90 минут. Правила тарификации этого тарифа будут такими: 85 рублей плюс 57 рублей за вторую и каждую последующую поездку на метро. Правильное решение получится с использованием динамического программирования, как в предыдущем решении, с тарификацией последней группы поездок с номерами от до по правилам тарифа «90 минут+».
ans = [10**9] * (n + 1)
ans[0] = 0
for i in range(1, n + 1):
    ans[i] = 57 + ans[i - 1]
    count_subway = subway[i]
    j = i - 1
    while j >= 1 and time[i] - time[j] <= 90:
        count_subway += subway[j]
        price = 85 + max(0, count_subway - 1) * 57
        ans[i] = min(ans[i], ans[j - 1] + price)
        j -= 1
print(ans[-1])
Наше решение на C++
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);
    int n;
    cin >> n;
    vector<long long> moment(n);
    vector<bool> metro(n);
    long long day = 0;
    int previous = -1;
    for (int i = 0; i < n; i++) {
        string kind, clock;
        cin >> kind >> clock;
        int minutes = stoi(clock.substr(0, 2)) * 60 + stoi(clock.substr(3, 2));
        if (minutes < previous) day++;
        previous = minutes;
        moment[i] = day * 1440 + minutes;
        metro[i] = kind == "M";
    }
    const int WIDTH = 10;
    const int STATES = 1 << WIDTH;
    const long long INF = LLONG_MAX / 4;
    vector<long long> current(STATES, INF), following(STATES, INF);
    current[0] = 0;
    for (int i = 0; i < n; i++) {
        fill(following.begin(), following.end(), INF);
        int busMask = 1;
        vector<int> metroBits;
        for (int k = 1; k < WIDTH && i + k < n && moment[i + k] - moment[i] <= 90; k++) {
            if (metro[i + k]) metroBits.push_back(k);
            else busMask |= 1 << k;
        }
        auto relax = [&](int mask, long long cost) {
            int shifted = mask >> 1;
            if (cost < following[shifted]) following[shifted] = cost;
        };
        for (int mask = 0; mask < STATES; mask++) {
            long long cost = current[mask];
            if (cost >= INF) continue;
            if (mask & 1) {
                relax(mask, cost);
                continue;
            }
            relax(mask | 1, cost + 57);
            int withTicket = mask | busMask;
            relax(withTicket, cost + 85);
            if (!metro[i]) {
                for (int bit : metroBits) {
                    if (!(mask >> bit & 1)) relax(withTicket | (1 << bit), cost + 85);
                }
            }
        }
        swap(current, following);
    }
    cout << current[0] << "\n";
    return 0;
}
5. Все на съезд!
В 2025 году в Берляндии впервые будет проводиться трёхдневный межпланетный съезд по вопросам проведения олимпиад по информатике. Доклады съезда разбиты на 12 секций, и теперь организаторам необходимо распределить секции по дням: в каждый день будут проводиться 4 секции.
Известно, что в съезде примут участие человек. Каждый участник съезда выбрал 3 секции, которые он хочет посетить. Но поскольку в один день секции будут проводиться одновременно, каждый участник в один день может присутствовать не более чем на одной секции. Поэтому если в один день будут идти две или три секции, выбранные каким-то участником, то он всё равно сможет посетить только одну из них. Если же выбранные секции будут проходить в разные дни, участник сможет посетить их все.
Для того чтобы съезд принёс как можно больше пользы, необходимо составить расписание съезда таким образом, чтобы суммарное число секций, посещённых всеми участниками, было как можно больше. Помогите оргкомитету составить такое расписание.
Формат входных данных
Первая строка входных данных содержит целое число () — количество участников съезда.
В каждой из следующих строк даны 3 попарно различных натуральных числа, не превосходящие 12, — номера секций, которые хочет посетить один из участников.
Формат выходных данных
Программа должна вывести 3 строки, в каждой из которых должны быть 4 числа через пробел — номера секций, проводимых в первый, второй и третий день съезда соответственно. Каждое из чисел от 1 до 12 должно встречаться в выводе ровно один раз. Если возможных оптимальных расписаний несколько, можно вывести любое из них.
Система оценки
Решения, правильно работающие, когда , будут оцениваться в 10 баллов.
Решения, правильно работающие, когда , будут оцениваться в 20 баллов.
Решения, правильно работающие, когда , будут оцениваться в 20 баллов.
Решения, правильно работающие, когда , будут оцениваться в 75 баллов.
Замечание
В примере из условия расписание составлено так, что второй и третий участник посетят все желаемые секции, а первый — две секции (5 и одну из секций 1, 6). Таким образом, суммарно будут посещены 8 секций. Можно показать, что этот результат улучшить нельзя.
| стандартный ввод | стандартный вывод |
|---|---|
3 5 6 1 6 7 9 1 9 7 | 1 11 6 12 10 5 7 8 9 2 3 4 |
Официальный разборСначала попробуйте решить сами
Наше решение на C++Полный код на C++17
Официальный разбор
Автор задачи: Елена Андреева.
Подготовка задачи: Семён Кухаренко.
При достаточно поставить желаемые секции единственного слушателя в разные дни.
При также можно полностью удовлетворить обоих участников. Для этого разнесём в разные дни секции первого участника, а потом ещё не распределённые секции второго поставим так, чтобы он мог посетить все три.
При всегда существует расписание, позволяющее двум участникам посетить все три желаемые лекции, а третьему — две из трёх, при этом полностью удовлетворить всех трёх не всегда возможно (это показано в примере из условия). Оптимальное расписание можно найти следующим жадным алгоритмом: распределим секции по очереди начиная с той, в которой заинтересовано больше всего участников. Каждый раз будем ставить секцию в такой день, где она принесёт больше всего пользы (то есть где на неё попадёт больше всего заинтересованных участников, учитывая уже распределённые секции). Перебором случаев (различных распределений участников по секциям) можно показать, что при всех возможных комбинациях желаемых секций этот алгоритм находит оптимальное решение.
Полное решение задачи заключается в переборе всех вариантов расписания. Такое решение может набирать разное количество баллов в зависимости от сделанных оптимизаций.
При можно перебрать все возможные варианты расписания, а потом для каждого из участников посчитать, сколько из интересующих его секций он сможет посетить при данном расписании. Перебор расписаний можно организовать следующим образом: будем для каждой секции перебирать, в какой из дней она будет проведена, при этом для каждого дня запомним, сколько секций мы туда уже поставили, и не будем ставить новые секции в дни, в которые уже назначены четыре секции. При этом мы переберём всего расписаний, для каждого из них за посчитаем суммарное число посещений. Можно также заметить, что порядок следования дней не влияет на ответ. Следовательно, количество перебираемых расписаний можно уменьшить в 6 раз, если предположить, например, что первая секция всегда стоит в первый день, а секция с минимальным номером, стоящая не в первый день, стоит во второй день.
Это решение можно улучшить. Заметим, что количество различных пожеланий участников (т.е. троек интересных секций) невелико (всего ). Для каждой возможной тройки секций , , сохраним wishes[a][b][c] — количество человек, желающих её посетить, и при проверке расписания вместо подсчёта числа посещённых секций для каждого человека будем считать это число для тройки и умножать результат на значение wishes[a][b][c]. Тогда ответ мы найдём приблизительно за действий.
Ниже приведён код решения на языке Python с применением всех оптимизаций. В этом решении используется нумерация с нуля как для секций, так и для дней.
wishes = [[[0 for _ in range(12)] for _ in range(12)] for _ in range(12)]

ans = -1          # макс. число посещений
res = [-1] * 12   # оптимальное расписание
plan = [-1] * 12  # перебираемое расписание
cnt = [0] * 3     # число уже поставленных секций в каждый день

def calc_vis_for_part(a, b, c): # считаем, сколько секций из тройки можно посетить
    if plan[a] == plan[b] and plan[b] == plan[c]:
        return 1
    if plan[a] == plan[b] or plan[b] == plan[c] or plan[a] == plan[c]:
        return 2
    return 3

def check():  # считаем суммарное число посещений для plan
    cnt = 0
    for a in range(12):
        for b in range(a + 1, 12):
            for c in range(b + 1, 12):
                cnt += calc_vis_for_part(a, b, c) * wishes[a][b][c]
    return cnt

# Рекурсивная функция перебора расписания
def gen(i):  # i - номер секции, которую будем распределять
    global ans, res, cnt, plan
    if i == 12:   # расписание сформировано, выполняем проверку
        nw = check()
        if nw > ans:
            ans = nw
            res = plan.copy()
        return
    for t in range(3):
        # проверяем, что мы не можем назначить секцию в третий день
        # если во второй день ещё не назначена ни одна секция
        if t == 2 and cnt[1] == 0:
            break
        if cnt[t] < 4:   # если в день t есть свободные места
            cnt[t] += 1  # назначаем секцию i в день t
            plan[i] = t
            gen(i + 1)   # вызываем рекурсивно алгоритм перебора
            plan[i] = -1
            cnt[t] -= 1

n = int(input())
for _ in range(n):
    a, b, c = map(int, input().split())
    # вычитаем 1 из номера секции, чтобы перейти в ноль-нумерацию
    # и упорядочиваем пожелания участника, чтобы a < b < c
    a, b, c = sorted([a - 1, b - 1, c - 1])
    wishes[a][b][c] += 1  # учитываем пожелания участника

# первую секцию поставим в первый день
# везде используется ноль-нумерация
plan[0] = 0
cnt[0] = 1
gen(1)

# выводим расписание
f = [[] for _ in range(3)]
for i in range(12):
    f[res[i]].append(i + 1)

for i in range(3):
    for j in range(4):
        print(f[i][j], end=' ')
    print()
В приведённом выше решении используется рекурсивный алгоритм перебора расписания. Но поскольку количество дней секций невелико и фиксировано, то вместо рекурсивного перебора можно использовать вложенные циклы. Например, будем считать, что первая секция стоит в первый день, номера оставшихся трёх секций первого дня переберём тремя вложенными циклами. Из оставшихся секций выберем секцию с минимальным номером и поставим её во второй день, другие три секции второго дня переберём вложенными циклами. Такое решение, вероятно, будет понятней для начинающих.
n = int(input())

# В словаре count считаем количество участников
# выбравших данную тройку секций
count = dict()
for i in range(n):
  part = tuple(sorted(map(int, input().split())))
  count[part] = count.get(part, 0) + 1

best_count = 0
best_ans = []

# d11, d12, d13, d14 - номера секций первого дня
d11 = 1
for d12 in range(2, 13):
  for d13 in range(d12 + 1, 13):
    for d14 in range(d13 + 1, 13):
      # day1 - список секций дня 1
      day1 = [d11, d12, d13, d14]
      # day23 - список нераспределённых секций
      day23 = [i for i in range(2, 13) if i not in day1]
      # 0, i1, i2, i3 - индексы элементов из списка day23
      # которые будут расставлены в день 2
      for i1 in range(1, len(day23)):
        for i2 in range(i1 + 1, len(day23)):
          for i3 in range(i2 + 1, len(day23)):
            # day2 - список секций дня 2
            day2 = [day23[0], day23[i1], day23[i2], day23[i3]]
            # day3 - список секций дня 3
            day3 = [i for i in range(2, 13) if i not in (day1 + day2)]
            curr_count = 0
            # Перебираем все пожелания и считаем количество выполненных
            for part in count:
              for day in (day1, day2, day3):
                if part[0] in day or part[1] in day or part[2] in day:
                  curr_count += count[part]
            if curr_count > best_count:
              best_count = curr_count
              best_ans = (day1, day2, day3)
for day in best_ans:
  print(*day)
Наше решение на C++
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);
    int n;
    cin >> n;
    map<array<int, 3>, int> wishes;
    for (int i = 0; i < n; i++) {
        array<int, 3> sections;
        for (int& s : sections) {
            cin >> s;
            s--;
        }
        wishes[sections]++;
    }
    vector<pair<array<int, 3>, int>> groups(wishes.begin(), wishes.end());
    array<int, 12> dayOf;
    array<int, 3> used{};
    array<int, 12> bestDays{};
    long long bestScore = -1;
    function<void(int)> search = [&](int section) {
        if (section == 12) {
            long long score = 0;
            for (auto& [sections, count] : groups) {
                int a = dayOf[sections[0]], b = dayOf[sections[1]], c = dayOf[sections[2]];
                int distinct = 1 + (b != a) + (c != a && c != b);
                score += (long long)distinct * count;
            }
            if (score > bestScore) {
                bestScore = score;
                bestDays = dayOf;
            }
            return;
        }
        for (int day = 0; day < 3; day++) {
            if (used[day] == 4) continue;
            used[day]++;
            dayOf[section] = day;
            search(section + 1);
            used[day]--;
            bool firstInEmptyDay = used[day] == 0;
            if (firstInEmptyDay) break;
        }
    };
    search(0);
    for (int day = 0; day < 3; day++) {
        vector<int> list;
        for (int s = 0; s < 12; s++)
            if (bestDays[s] == day) list.push_back(s + 1);
        for (int k = 0; k < 4; k++) cout << list[k] << (k + 1 < 4 ? ' ' : '\n');
    }
    return 0;
}
Сначала решите сами
Возьмите столько времени, сколько было на олимпиаде, и только потом открывайте разбор.
Другие туры
2026/27
- Школьный этап, 9–11 классы5 задач
- Школьный этап, 7–8 классы6 задач
- Школьный этап, 5–6 классы5 задач
2025/26
- Школьный этап, 9–11 классы5 задач
- Школьный этап, 7–8 классы6 задач
- Школьный этап, 5–6 классы5 задач
- Муниципальный этап, 9–11 классы5 задач
- Муниципальный этап, 7–8 классы6 задач
2024/25
- Школьный этап, 9–11 классы5 задач
- Школьный этап, 7–8 классы7 задач
- Школьный этап, 5–6 классы5 задач
- Муниципальный этап, 9–11 классы5 задач
- Муниципальный этап, 7–8 классы7 задач
2023/24
- Школьный этап, 9–11 классы5 задач
- Школьный этап, 7–8 классы7 задач
- Школьный этап, 5–6 классы5 задач
- Муниципальный этап, 9–11 классы5 задач
- Муниципальный этап, 7–8 классы7 задач